Pré-rendre un site React : ce qui a marché, ce qui a cassé
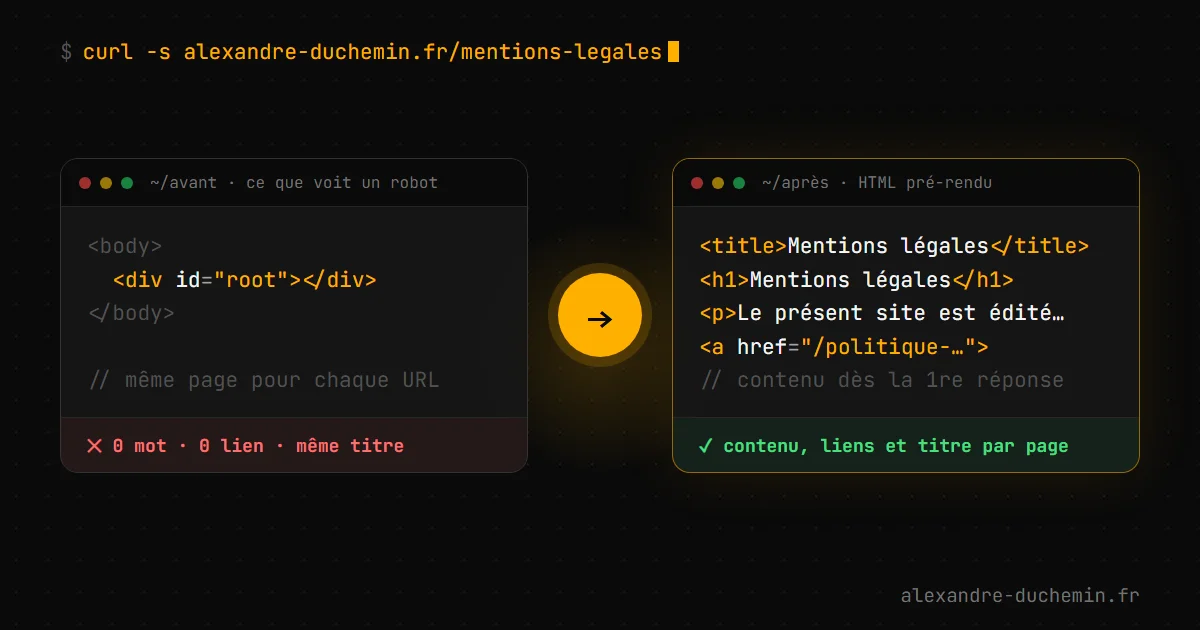
Un audit automatisé de mon portfolio m'a signalé « absence de mentions légales et de politique de confidentialité ». Sauf que ces pages existaient, liées dans le footer. Un simple curl a suffi à comprendre : le serveur renvoyait exactement la même page vide pour chaque URL. Tout le contenu n'apparaissait qu'après l'exécution de JavaScript.
Le problème : une SPA envoie une coquille vide
Mon site était une application React en rendu client pur. Voilà ce que recevait un robot, quelle que soit la page demandée :
<div id="root"></div>Aucun texte, aucun lien, et le même <title> et la même URL canonique sur toutes les pages, puisqu'il n'y a qu'un seul index.html. Google sait exécuter JavaScript, mais avec un délai et de façon moins fiable. La plupart des autres robots ne le font pas : aperçus de liens sur les réseaux, outils d'audit, certains moteurs de recherche.
Les options
Un navigateur headless au build (Puppeteer) : j'avais un script, jamais lancé en production. Il demande Chromium dans l'image et dépend de délais d'attente : fragile.
Next.js : la solution classique, mais une réécriture complète pour un site qui fonctionne.
React Router 7 en « framework mode » : pré-rendu au build, sans navigateur, en gardant mes routes et mes composants.
J'ai retenu la troisième, en génération statique (SSG) plutôt qu'en rendu serveur (SSR). Mon contenu change rarement : un serveur Node à faire tourner et à surveiller n'apporterait rien, nginx sert simplement des fichiers. Le prix à payer : le contenu est figé jusqu'au prochain build.
Comment ça marche
Chaque page publique devient un module de route avec un loader, qui lit les données via l'API au moment du build, et un meta, qui produit le title, la description, la canonical, l'Open Graph et le JSON-LD.
export async function loader() {
  const [profile, projects] = await Promise.all([
    fetchProfile(),
    fetchProjects(),
  ])

  return {
    profile,
    projects,
  }
}

export const meta: MetaFunction<typeof loader> = () => {
  return buildPageMeta({
    title: SITE_TITLE,
    description: SITE_DESCRIPTION,
    path: "/",
  })
}
Le loader n'a volontairement pas de catch. Si l'API est en panne, le build échoue et la version en ligne reste intacte : un build « réussi » qui publie des pages vides serait pire.
Le build tourne dans un conteneur Docker à usage unique. Il génère le site dans une version datée, puis bascule un lien symbolique de façon atomique. Pendant un rebuild, j'ai envoyé 300 requêtes à la suite sur le site : 300 réponses 200.
Les pièges que je n'avais pas anticipés
La CSP bloque l'hydratation
React Router injecte dans chaque page des scripts inline pour l'hydratation. Ma politique script-src 'self' les bloquait : le site s'affichait, mais plus rien n'était interactif. Autoriser 'unsafe-inline' aurait affaibli la protection. À la place, le build calcule le hash sha256 de chaque script inline et l'écrit dans une balise meta propre à la page :
<meta http-equiv="Content-Security-Policy"
      content="script-src 'self' 'sha256-…' 'sha256-…'">
Les hashes voyagent avec le HTML qu'ils protègent, et script-src reste strict.
Le rendu doit être identique au build et dans le navigateur
Les dates : le build tourne en UTC, le visiteur est en Europe/Paris. Une date proche de minuit ne s'affichait pas pareil des deux côtés. Solution : fixer le fuseau dans le formatage.
DOMPurify n'existe pas côté Node (pas de DOM) :
isomorphic-dompurifyfournit la même API dans les deux environnements.Une valeur qui change entre le build et la visite, comme l'année du footer, demande
suppressHydrationWarning.
Les animations au scroll clignotaient
Le contenu était visible dans le HTML, puis masqué par JavaScript pour être animé : un clignotement à chaque chargement. Les blocs animés sont maintenant masqués dès le HTML par CSS. Sans JavaScript, ou avec « réduire les animations » activé, tout reste visible.
Un formulaire dans du HTML statique
Avant l'hydratation, envoyer le formulaire de contact aurait déclenché un envoi natif du navigateur, avec le message dans l'URL. Le bouton reste désactivé tant que React n'a pas pris la main.
Ce qui a cassé en production, deux fois
Malgré des tests dans un vrai navigateur, deux bugs sont passés.
Le build échouait sur un blog vide. Avec le pré-rendu, React Router refuse qu'une route ait un
loadersi aucun chemin ne lui est pré-rendu. Ma base de développement contenait un article, celle de production aucun : build en échec, site en 404. La route des articles a maintenant deux variantes, choisies selon l'état de l'API. Leçon : tester sur une base vide, qui est l'état d'un premier déploiement.Les images envoyées via l'admin passaient en 404. Pour servir l'image de partage, j'avais ajouté
jpgetwebpà la règle nginx des fichiers statiques. Or nginx évalue les règles par expression régulière avant un simple préfixe : elle interceptait aussi/api/…webp. Chrome affichait des images cassées, Edge non, sans doute grâce à son cache. Correction :location ^~ /api. Leçon : tester au moins un fichier réel pour chaque type de route.
Le résultat
Chaque page a son propre title, sa canonical et son Open Graph dans le HTML brut, et les mentions légales sont dans le footer sans JavaScript.
Dans mes tests, Lighthouse sur l'accueil : performance 93 (86 avant), SEO 100, accessibilité 100, bonnes pratiques 100.
Le décalage de mise en page (CLS) passe de 0,275 à 0.
Le rôle de l'IA
J'ai mené ce chantier avec un assistant IA (Claude Code) comme binôme : pour explorer les options, écrire le code répétitif et automatiser des vérifications (tests dans un navigateur, audit du HTML généré). Mais les deux bugs de production sont passés à travers : mes données de test étaient trop proches de celles de développement. L'IA propose ; c'est à moi de cadrer, de décider quoi vérifier, et de vérifier.
À retenir
Une SPA envoie une page vide aux robots : un
curlle montre en dix secondes.Si le contenu change peu, le pré-rendu statique suffit. Le rendu serveur se justifie quand il change à chaque visite.
Faire échouer le build plutôt que publier des pages vides.
Tester la CSP et l'hydratation dans un vrai navigateur, sur une base vide comme sur une base remplie.
Une limite à connaître : après une modification dans l'admin, il faut relancer le build pour que le contenu public suive.